
Guía
Cómo scrapear una página con scroll infinito sin programar
Actualizado: 23 de septiembre de 2026
Por qué el scroll infinito rompe a la mayoría de los scrapers
En una página con scroll infinito los resultados no están todos en el HTML: aparecen de a tandas cuando bajás. Muchas extensiones resuelven esto bajando y esperando un tiempo fijo, por ejemplo dos segundos. Si el sitio tarda tres, la tanda nueva todavía no llegó, el scraper cree que se terminó la lista y te entrega la mitad de las filas sin avisarte.
El otro problema es el contrario: cuando la página vuelve a dibujar la lista al bajar, el scraper lee otra vez los mismos elementos y el export sale con duplicados.
1. Elegí un elemento de la lista
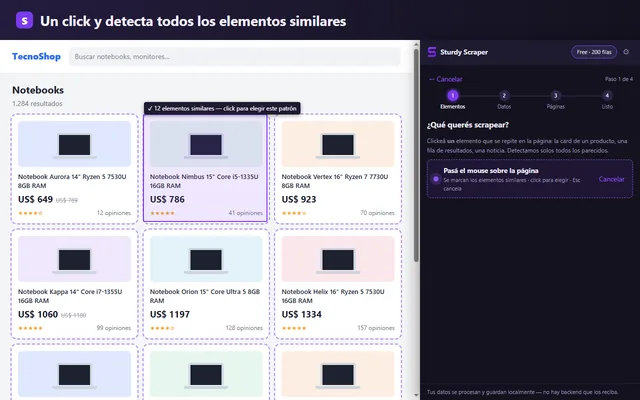
Abrí la página y en Sturdy Scraper tocá Nuevo scraper → Seleccionar contenedor. Hacé click en una tarjeta o fila de resultados: la extensión marca todas las parecidas y te dice cuántas ve en ese momento. Después agregá las columnas (título, precio, link, imagen) con clicks sobre esa misma tarjeta.
2. Elegí “Scroll infinito” como paginación
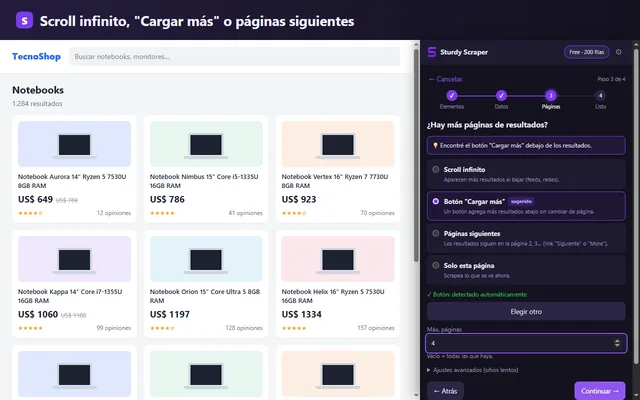
En el paso de paginación, la extensión intenta detectar sola cómo carga más resultados la página. Si no lo detecta, elegí Scroll infinito a mano. Conviene poner un máximo de páginas para una primera prueba corta.
Mientras corre, en vez de esperar un tiempo fijo, la extensión observa la página y avanza recién cuando aparecen elementos nuevos. Si deja de aparecer contenido después de varios intentos, termina y te lo dice: “la página dejó de cargar más”.
Listas que scrollean dentro de un panel
Algunos sitios no mueven la página entera: la lista está en un panel con su propia barra de scroll (mapas, bandejas de entrada, paneles laterales). Sturdy Scraper busca ese panel y scrollea adentro, así que funciona también en ese caso.
Sin duplicados falsos, sin filas perdidas
Lo que se vuelve a leer al scrollear no se repite en el export. Y si la lista tiene de verdad dos elementos idénticos (dos productos con el mismo nombre y precio), se exportan los dos: solo se descarta lo que ya se había leído.
3. Exportá
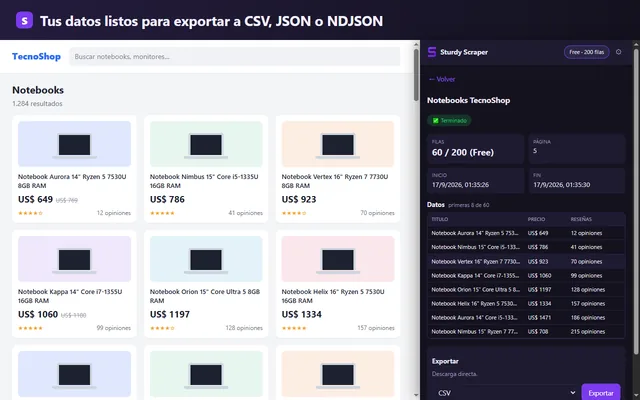
Al terminar, exportá a CSV para Excel o Google Sheets, o a JSON/NDJSON para procesarlo con otra herramienta. Si son muchas filas, el archivo se escribe por partes directo al disco sin llenar la memoria del navegador.
Antes de empezar
Usalo en datos públicos y respetando los términos de cada sitio. Si un sitio pide iniciar sesión o bloquea el acceso automatizado, no insistas. Todo lo que extraés queda en tu navegador y no pasa por ningún servidor.
Preguntas frecuentes
¿Cuántas filas puedo sacar gratis?
El plan Free trae todas las funciones hasta 200 filas por scrape, sin cuenta ni tarjeta. Pro (USD 9 por mes) quita el límite.
¿Qué pasa si el sitio tarda en cargar?
La extensión espera a que aparezcan elementos nuevos en la página en lugar de un tiempo fijo, así que un sitio lento no te deja filas afuera.
¿Funciona con botones de “Cargar más”?
Sí, es otro modo de paginación: la extensión clickea el botón y espera a que la lista crezca antes de seguir.
Seguí leyendo
Guía: datos de una web a Excel · Alternativa a Instant Data Scraper · Guía: monitorear precios · Novedades